選擇輸入模型
圖片採用英文標示,說明操作流程與資料路徑;實際介面以目前 App 與 macOS 為準。
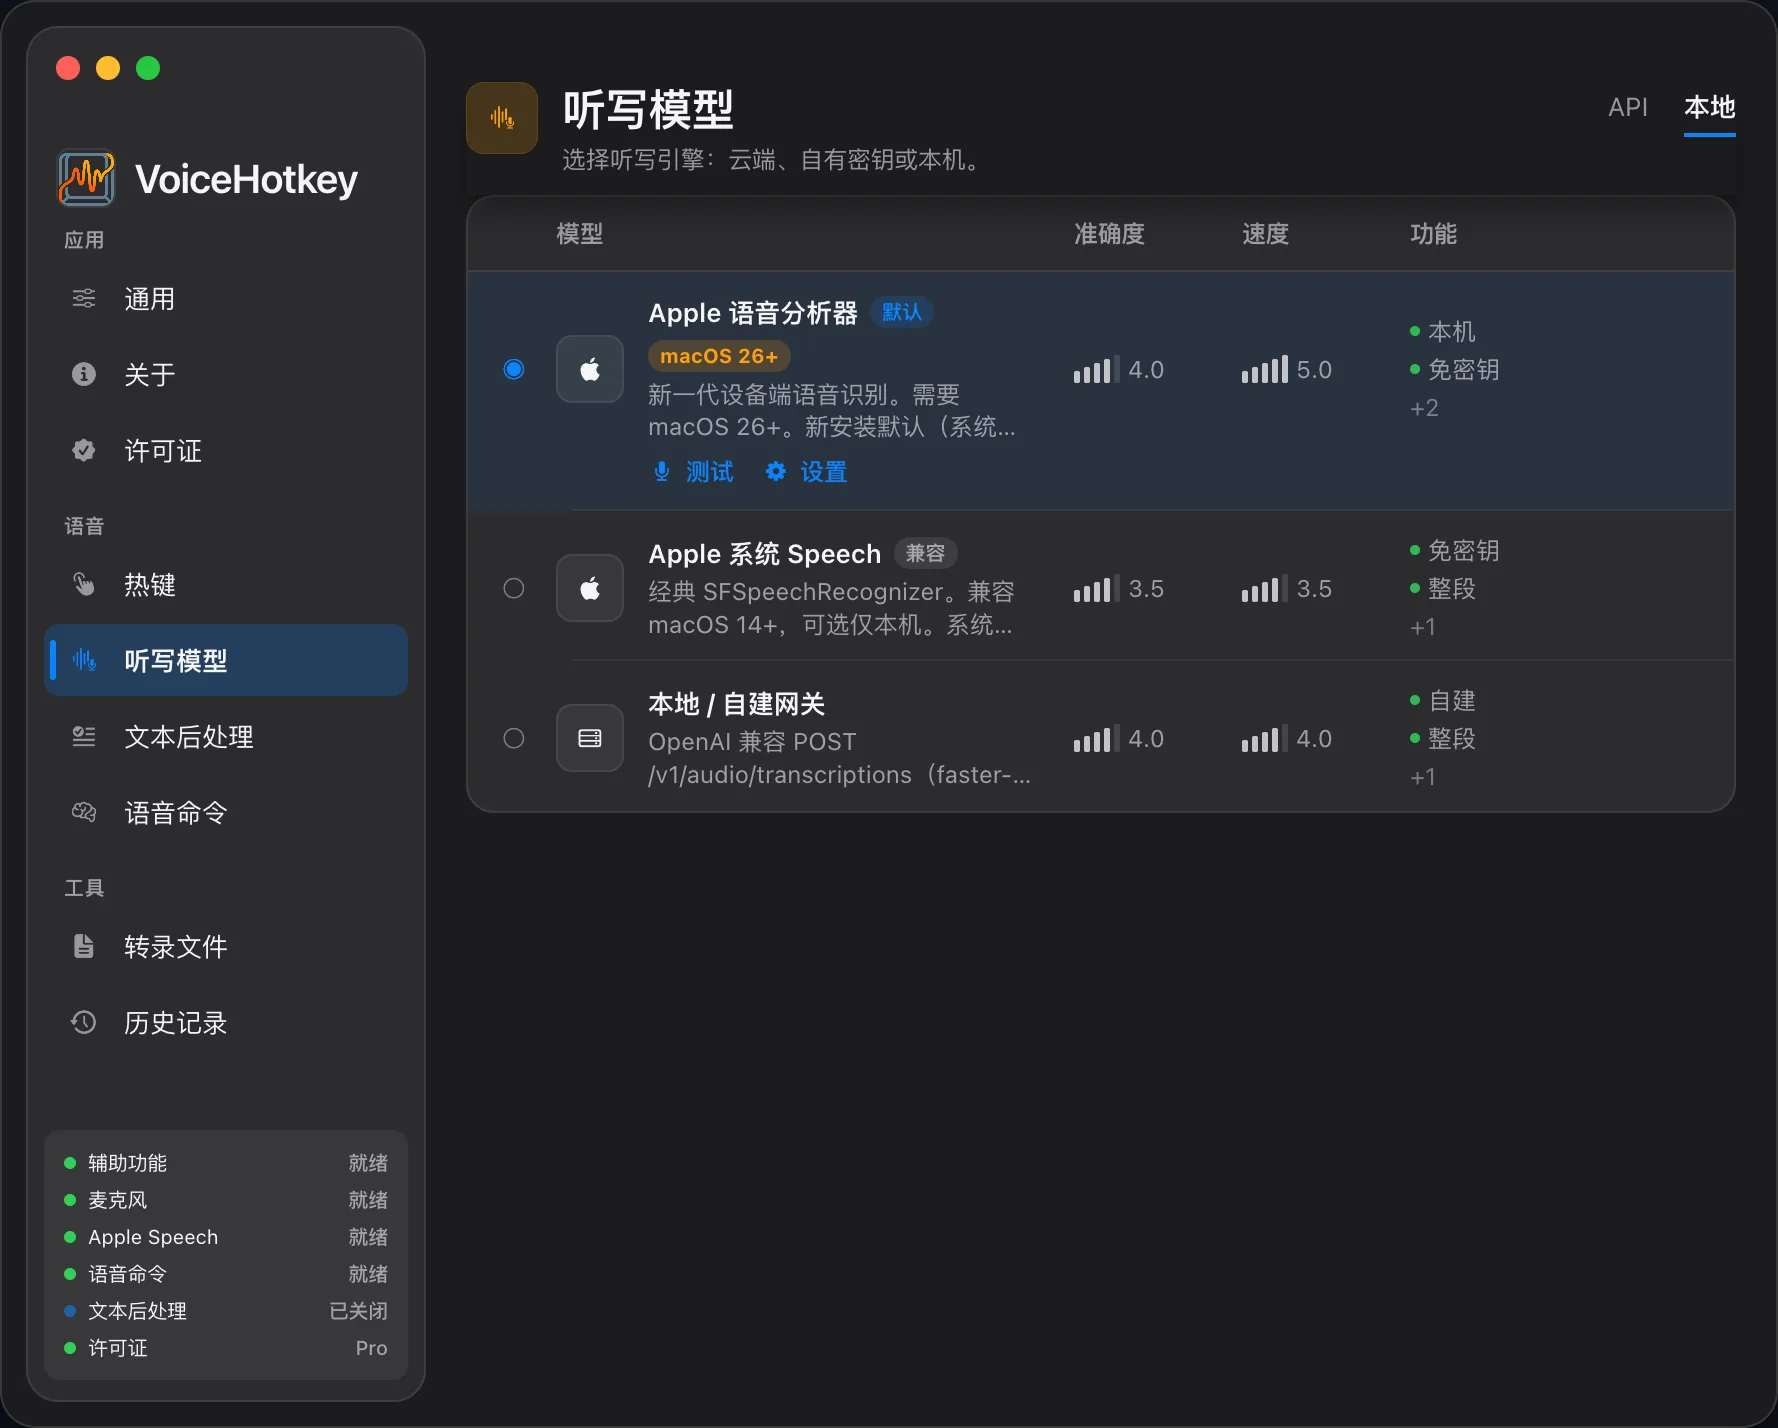
在 設定 → 輸入模型 中選擇引擎。首次啟動預設使用 Apple:macOS 26+ 自動選擇 SpeechAnalyzer,較早的受支援系統使用舊版 Apple Speech。
模型可用性: Fun-ASR-Nano 與 SenseVoice Small 均可下載、選擇並在本機辨識;安裝模型後可離線使用。
語音輸入的方案門檻
Section titled “語音輸入的方案門檻”| Free 可用 | 試用 / Pro 可用 |
|---|---|
| Apple;豆包(自備金鑰的雲端服務) | 目前可用目錄 |
| 內建本機 SenseVoice Small、Qwen3-ASR 0.6B / 1.7B、Whisper Turbo / Small / Distil、MOSS-0.9B、Fun-ASR-Nano、FireRedASR、Parakeet TDT | 另含百鍊、MiMo、Azure、Gemini、OpenAI Speech、Groq、ElevenLabs、Soniox、NVIDIA Speech NIM、OpenAI 兼容端點等 |
OpenAI 兼容或 faster-whisper 等自建端點即使位於 localhost,仍需試用或 Pro。上述門檻是實時語音輸入的引擎權限;App 內檔案轉寫另需試用或 Pro。
| 類型 | 處理方式與準備 |
|---|---|
| Apple SpeechAnalyzer(macOS 26+) | 在本機辨識;系統語言資源可能需要下載,無需雲端 API Key |
| 舊版 Apple Speech | 常規模式可能使用 Apple 雲端;僅本機模式強制本機辨識,語言或系統不支援時可能失敗 |
| 內建本機模型 | 在模型頁下載並安裝所需執行時與權重,確認就緒後使用;安裝後的辨識在本機完成,無需 API Key |
| 雲端服務 | 將音訊傳送給所選服務商;按服務要求填寫金鑰及端點 |
| 兼容 / 自建服務 | 音訊傳送到你配置的端點;網路需求取決於部署位置 |
內建本機模型在錄音結束後對整段音訊推理,不是邊說邊出字。模型檔案保存在本機 Application Support 目錄。語言支援與可選模型以 App 目錄為準。
降噪與硬體加速
Section titled “降噪與硬體加速”設定 → 一般 → 麥克風 的 GTCRN 降噪選項用於受支援的 sherpa-onnx 本機辨識路徑,並非所有 Apple、雲端或 MOSS 錄音都會經過它。效果取決於音訊和模型。
Whisper 可使用已安裝的 CoreML 加速資源;可用性與回退路徑取決於模型、執行時和硬體,不保證固定速度或功耗。
API Key 與音訊去向
Section titled “API Key 與音訊去向”你填寫的提供商金鑰保存在 macOS 鑰匙圈。內建本機模型在本機處理音訊;雲端引擎和舊版 Apple Speech 的資料去向不同,見 BYOK 與資料去向。
檔案轉寫模型
Section titled “檔案轉寫模型”在 設定 → 檔案轉寫 → 選擇模型 可獨立選擇檔案轉寫模型,並共享提供商金鑰。App 內檔案轉寫要求 試用 / Pro,同時仍檢查所選引擎權限。見檔案轉寫。
僅本機模式 允許 Apple 與內建本機引擎;舊版 Apple 會被強制為本機辨識。其它引擎的相關端點必須使用 localhost、127.0.0.1 或 ::1,並滿足方案門檻。請提前安裝離線模型和系統語言資源。
部分引擎提供上下文、prompt 或詞典詞條,可填寫人名、品牌與術語;再用詞替換 修正辨識結果。
FireRed 的現行 zh_en 模型支援中文、英文及自動判斷,並非韓英混合模型。Parakeet 支援的 25 種語言包含英文,並不是英文之外另有 25 種。