选择输入模型
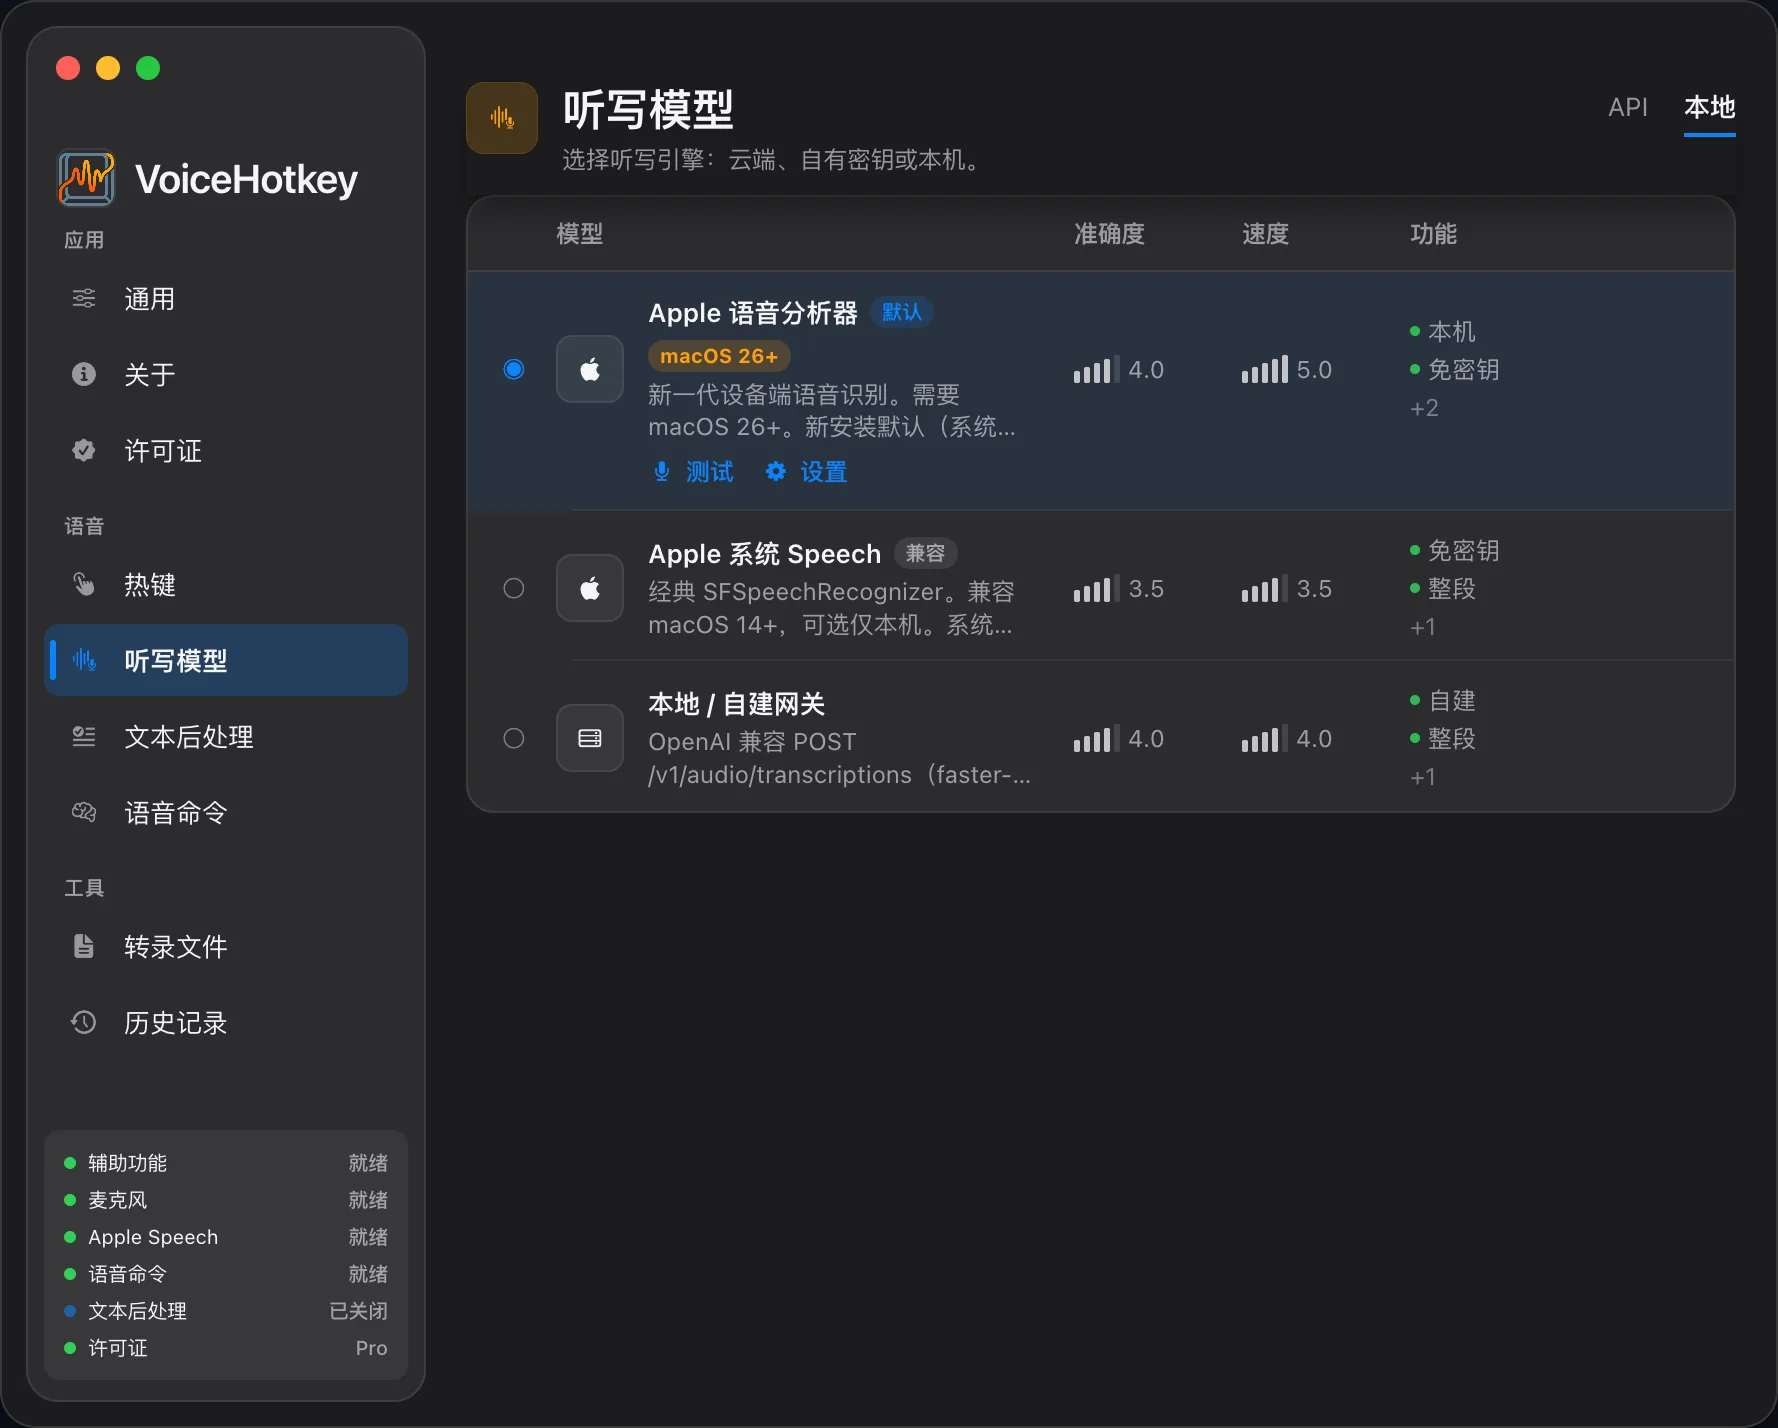
在 设置 → 输入模型 中选择引擎。首次启动默认使用 Apple:macOS 26+ 自动选择 SpeechAnalyzer,较早的受支持系统使用旧版 Apple Speech。
模型可用性: Fun-ASR-Nano 与 SenseVoice Small 均可下载、选择并在本机识别;模型安装后可离线使用。
语音输入的方案门槛
Section titled “语音输入的方案门槛”| Free 可用 | 试用 / Pro 可用 |
|---|---|
| Apple;豆包(自备密钥的云端服务) | 当前可用目录 |
| 内置本机 SenseVoice Small、Qwen3-ASR 0.6B / 1.7B、Whisper Turbo / Small / Distil、MOSS-0.9B、Fun-ASR-Nano、FireRedASR、Parakeet TDT | 另含百炼、MiMo、Azure、Gemini、OpenAI Speech、Groq、ElevenLabs、Soniox、NVIDIA Speech NIM、OpenAI 兼容端点等 |
OpenAI 兼容或 faster-whisper 等自建端点即使位于 localhost,仍需试用或 Pro。上述门槛是实时语音输入的引擎权限;App 内文件转写另需试用或 Pro。
| 类型 | 处理方式与准备 |
|---|---|
| Apple SpeechAnalyzer(macOS 26+) | 在本机识别;系统语言资源可能需要下载,无需云端 API Key |
| 旧版 Apple Speech | 常规模式可能使用 Apple 云端;仅本地模式强制本机识别,语言或系统不支持时可能失败 |
| 内置本机模型 | 在模型页下载并安装所需运行时与权重,确认就绪后使用;安装后的识别在本机完成,无需 API Key |
| 云端服务 | 将音频发送给所选服务商;按服务要求填写密钥及端点 |
| 兼容 / 自建服务 | 音频发送到你配置的端点;网络需求取决于部署位置 |
内置本机模型在录音结束后对整段音频推理,不是边说边出字。模型文件保存在本机 Application Support 目录。语言支持与可选模型以 App 目录为准。
降噪与硬件加速
Section titled “降噪与硬件加速”设置 → 通用 → 麦克风 的 GTCRN 降噪选项用于受支持的 sherpa-onnx 本机识别路径,并非所有 Apple、云端或 MOSS 录音都会经过它。效果取决于音频和模型。
Whisper 可使用已安装的 CoreML 加速资源;可用性与回退路径取决于模型、运行时和硬件,不保证固定速度或功耗。
API Key 与音频去向
Section titled “API Key 与音频去向”你填写的提供商密钥保存在 macOS 钥匙串。内置本机模型在本机处理音频;云端引擎和旧版 Apple Speech 的数据去向不同,见 BYOK 与数据去向。
文件转写模型
Section titled “文件转写模型”在 设置 → 文件转写 → 选择模型 可独立选择文件转写模型,并共享提供商密钥。App 内文件转写要求 试用 / Pro,同时仍检查所选引擎权限。见文件转写。
仅本地模式 允许 Apple 与内置本机引擎;旧版 Apple 会被强制为本机识别。其它引擎的相关端点必须使用 localhost、127.0.0.1 或 ::1,并满足方案门槛。请提前安装离线模型和系统语言资源。
部分引擎提供上下文、prompt 或词典词条,可填写人名、品牌与术语;再用词替换 修正识别结果。